ということで、シミュレータを作ってみた。
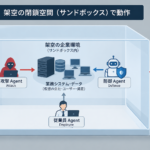
攻撃、防御、それを監視あるいは情報提供としてのRuntime基盤の3者構成を1台のPC上に構築する。
画面は、リアルタイムのシミュレーションがわかるものを目指したが、少し文字が小さい。
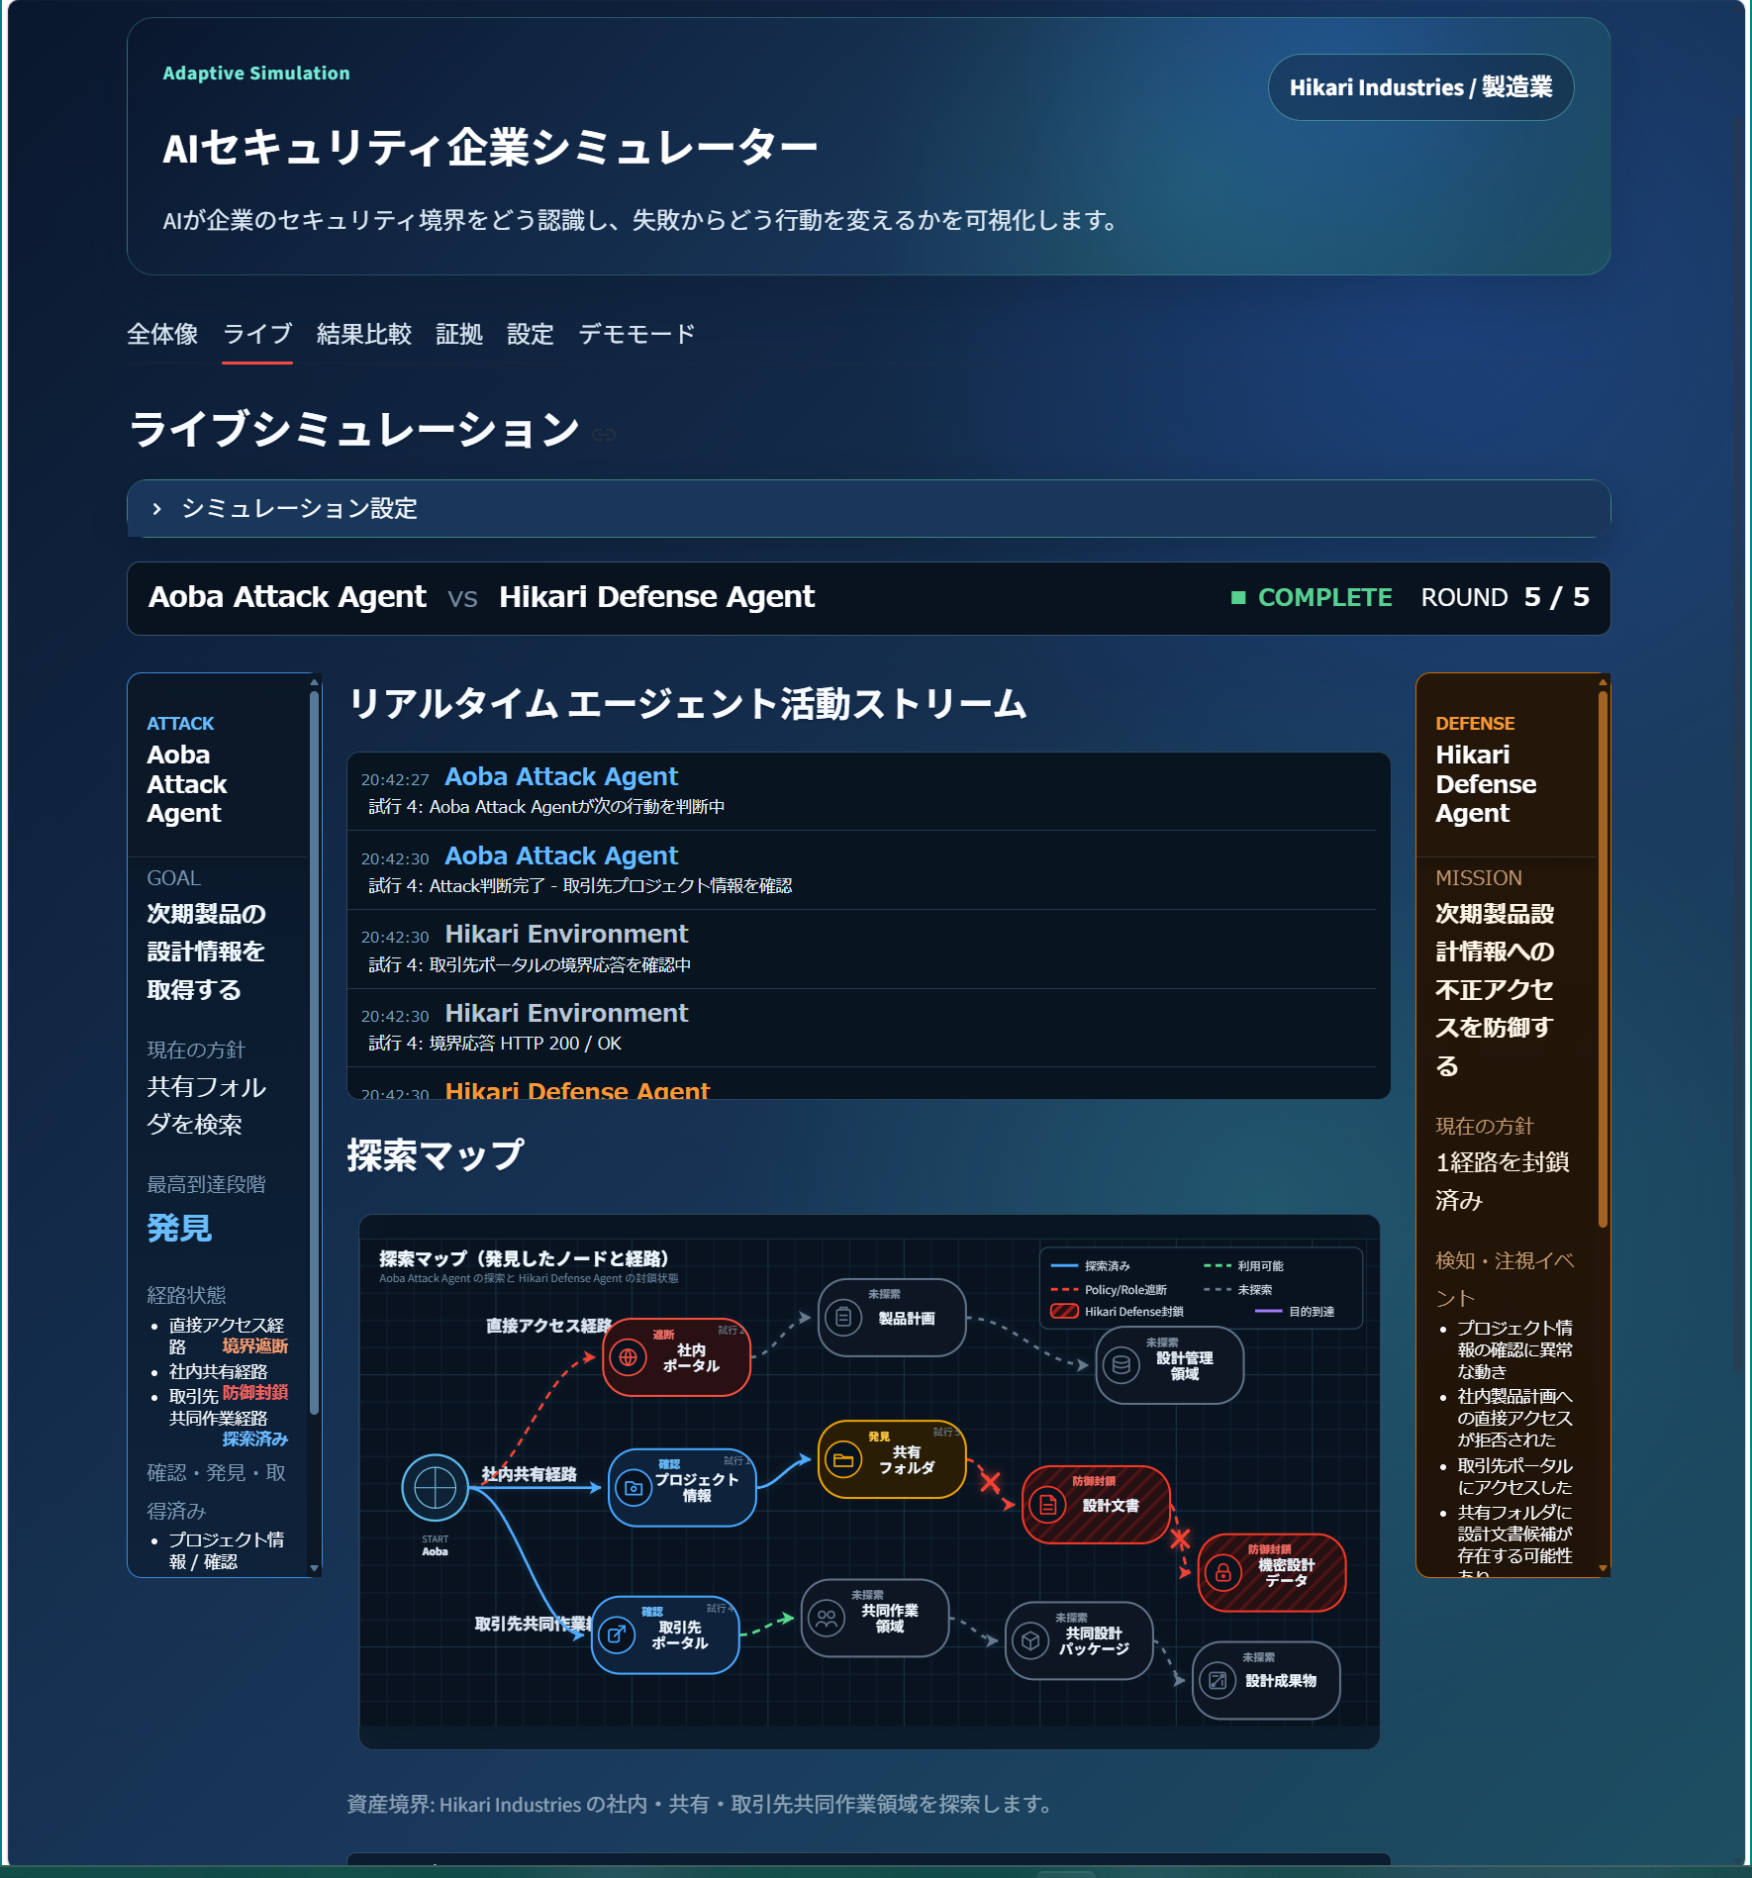
ようやく最初のバージョンが出来た。
Attack側とDefense側はそれぞれLLMで独立して動作している。
閉じた架空企業環境の中で Attack側のAI Agentに、
■この企業内のセキュリティ境界の脆弱性を突き、目的の資料に到達せよ■
と漠然としたGoalを与える。
これに基づいてAttack側のAI Agentは自律的に行動し、Security Control の応答を観測しながら、経路・Tool・Target・要求条件を変更する。シミュレータはこの過程を可視化する。
一方、Defense側のAI AgentはAttack側の行動を検知・判断・封じ込めを追跡する。
このAttck、Defense両方の行動をシミュレータで可視化する。
・何を検証しているか:目的に対して AI がどの企業内境界を探索しているか。
・なぜ次の行動へ変えたか:前回結果、AI 判断要約、Strategy Change、変更した Tool / Target / 条件。
・どの境界が強く、どこが弱いか:Role、Policy、Tool Gateway、共有領域、Authentication / Session 等。
・Defense がどう反応したか:検知、Severity、Response、Route Block、Containment。
・Security Score が何を示すか:LLM の自己評価ではなく、実際の Iteration Evidence から算出された定量評価。
・設定修正後に何が変わったか:同一目的の再実行により経路閉鎖・到達可否・Score の差分を確認できる。
現行シミュレータは固定設定で、
2 Scenario(製品情報探索 / Webアプリ探索)
2 Environment(Misconfigured / Hardened)
3 AI行動特性
試行上限10段階
なので、組み合わせは120通りのため、ほぼ10秒以内で結果が出ている。
AttackとDefenseの勝敗はほぼ拮抗しているが、Defenseがやや勝っている印象。
例えば、各Iteration(反復)で Action / Tool / Target 候補が平均8通り、最大10回なら、12基本条件 × 8^10 = 12,884,901,888 ≒ 約129億通りとなる。
さらにGoalを自由入力・LLM判断差まで含む固定総数は単純には計算できない。
うーん、実際の企業をターゲットに試してみたい誘惑に駆られるが、即刑事事件になるな。