LM Studio
LM Studioを使う際のパラメータ備忘録。
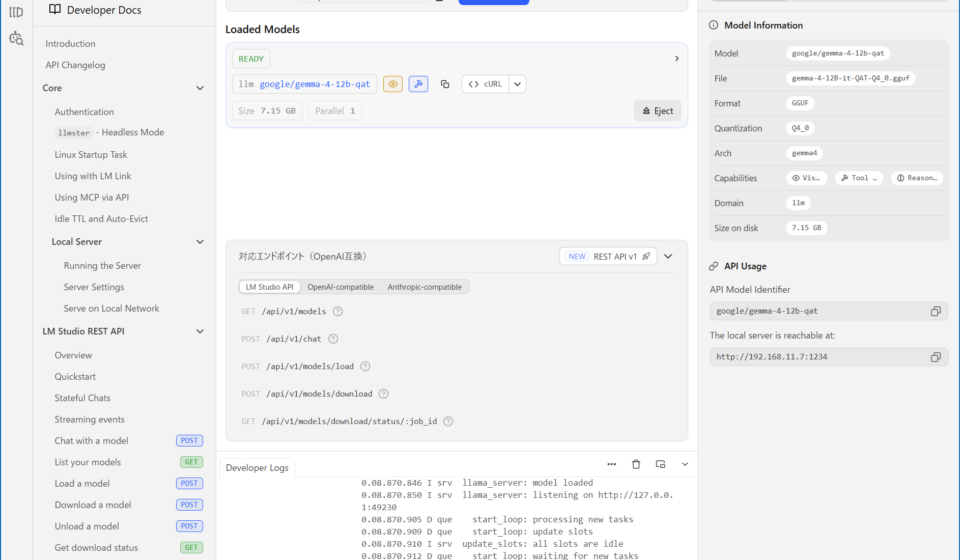
■12Bモデル(gemma-4-12B-qat)
・GPU Offload:
設定: 48(またはスライダーを最大まで)
理由: 16GBあれば12Bモデルのほぼ全レイヤーをVRAMに乗せられる。これを最大にすることで、CPUを介さずGPUのみで高速に処理され、安定性が増す。
・Context Length:
設定: 8192 または 16384
理由: 32768などの極端に大きな値にすると、VRAMを余計に消費し、モデルの挙動が不安定になることがある。まずは8192から試し、余裕があれば広げる。
・Max Tokens:
設定: 4096 以上
理由: これが「chat回答途中で切れる」のを防ぐ物理的な上限。ここを大きく設定することで、モデルが長い文章を書き切るための「スペース」を確保します。
・Temperature:
設定: 0.7 〜 0.8
理由: 最新のGPUであれば推論も速いため、少し温度を上げることで、より流暢で人間らしい表現を引き出せる。
■32Bモデル(Qwen2.5 VL 32B instruct)
12Bモデルとは「メモリ管理の戦略」が根本的に異なる。
・GPU Offload の調整(最重要)
32Bモデルを動かす際の最大の難所。
設定のコツ: スライダーを最大にするのではなく、**「VRAM(16GB)を使い切る直前まで」**上げる。(設定:46)
理由: 32Bモデルを無理やりVRAMに詰め込もうとして溢れる(OOM: Out of Memory)と、推論がクラッシュするか、極端に遅くなる。
目安: LM Studioの画面上部にある「Estimated Memory Usage」を見て、VRAMの消費が14GB〜15GB程度(16GBのギリギリまで使い切らない)になる位置(46の場合15.03GB)で調整する。残りは自動的に64GBのシステムメモリが補う形になる。
・Context Length(コンテキスト長)の抑制
12Bの時よりも、32Bの方がコンテキストの維持にコストがかかる。
推奨設定: 8192
理由: 32Bモデルで大きなコンテキスト(例: 32768など)を確保しようとすると、VRAMを大量に消費します。VRAMを「モデルの重み(知識)」を載せるために優先的に使う必要があるため、コンテキストはあえて少し控えめ(8192程度)にするのが、「途切れを防ぎつつ安定させる」ためのコツ。
・Max Tokens の設定(※評価バッチサイズ)
これは12Bの時と同じですが、32Bの方が「一回答の密度」が高いため、しっかり確保する必要があります。
推奨設定: 4096
理由: 32Bモデルはより高度な思考をするため、一度に生成する情報の量が多くなります。ここを小さくしすぎると、複雑な思考の途中で物理的に切れてしまいます。
・量子化(Quantization)の選択(重要)
モデルをダウンロードする際に選ぶ「量子化サイズ」が非常に重要です。
推奨: Q4_K_M または Q5_K_M
理由: 32Bモデルを「Q8_0(高精度)」などで動かそうとすると、メモリ消費が激しすぎて、GPUとCPUのやり取り(ボトルネック)が発生し、回答速度が極端に遅くなったり、メモリ不足で途切れたりしやすくなる。
バランス: Q4_K_M あたりであれば、16GBのVRAMと64GBのRAMの構成で非常にスムーズかつ賢く動作する。
まとめ:32Bモデル用の推奨設定まとめ
項目 推奨設定 12Bモデルとの違い
GPU Offload VRAMの約90%を占めるまで 12Bは「最大」で良いが、32Bは「手動調整」が必要。
Context Length 8192 32Bは重いため、あえて少し絞るのが安定のコツ。
Max Tokens 4096 同様。
Temperature 0.7 同様。
量子化サイズ Q4_K_M などを推奨 32Bを動かすなら、このあたりが速度と知能の黄金比。
運用のコツ:
32Bモデルは12Bに比べて「じっくり考える」性質があるため、回答の生成速度は落ちる。もし途中で止まったように見えても、数秒〜十数秒待つと動き出すことがあります。もしそれでも止まる場合は、やはりシステムプロンプトで**「一文ずつ丁寧に、最後まで書き切ってください」**と念押しするのが効果的。